Stav produktových dat v českém e-commerce: třetina produktů je bez popisu
 Jiří ŠtěpánekZakladatel Lasso
Publikováno
Prošli jsme strukturovaná produktová data 33 408 českých webů. Zhruba třetina produktových záznamů nemá popis a víc než polovina značku. V EAN a kategoriích jsou ale české weby před Německem i Polskem.
Produktová data v českém e-commerce jsou v něčem lepší, než se o nich říká, a v něčem překvapivě chudá. Prošli jsme veřejně dostupná strukturovaná data 33 408 českých webů a 6,9 milionu produktových záznamů. Zajímalo nás, která pole weby skutečně vyplňují, jak si stojí proti Slovensku, Polsku, Německu a Maďarsku a co chybějící údaje stojí, když má nový produkt co nejrychleji začít prodávat.
Ve zkratce:
- Zhruba každý třetí produktový záznam nemá ve strukturovaných datech popis.
- Víc než polovina neuvádí značku.
- EAN/GTIN má jen zhruba každý pátý záznam. Přesto ho české weby uvádějí častěji než weby v Německu, Polsku, Maďarsku i světový průměr.
Jak jsme postupovali. Zdroj: Web Data Commons, podmnožina schema.org Product z Common Crawl z října 2024 (vydáno v lednu 2025). Vzali jsme všechny weby s doménou .cz (33 408 domén, 6 914 424 produktových záznamů). Pro srovnání zemí jsme použili domény s alespoň 50 produkty v .cz, .sk, .pl, .de, .hu a celosvětově. „Vyplněnost pole“ je podíl produktových záznamů, jejichž markup dané pole obsahuje. Analýza: Python nad statistikami WDC po doménách, říjen 2026. Výsledky uvádíme jen za skupiny, nikdy za jednotlivé e-shopy. Všechna omezení najdete na konci článku.
Proč na tom záleží právě teď
Chybějící údaj dřív znamenal hlavně pomalejší schválení feedu. Dnes rozhoduje o tom, jestli se produkt vůbec zobrazí, a takových míst přibývá:
- AI vyhledávání čte data, ne vzhled stránky. Google spustil v říjnu 2025 Režim AI v češtině. Ve svých doporučeních k funkcím AI ve Vyhledávání radí, aby strukturovaná data odpovídala tomu, co je vidět na stránce, a údaje v Merchant Center byly aktuální. OpenAI má ve specifikaci produktového feedu pro ChatGPT popis i značku mezi povinnými poli. Právě ta dvě pole v našich datech chybí nejčastěji: třetina záznamů nemá popis a víc než polovina značku.
- Filtr ukáže jen produkty, které mají hodnotu vyplněnou. Když chybí značka, velikost nebo barva, produkt zmizí ve chvíli, kdy zákazník filtr zaškrtne. Baymard Institute řadí značku mezi pět typů filtrů, které by měl nabízet každý e-shop. Z jeho testů vyplývá, že když lidé nemůžou pořádně filtrovat, nenajdou ani produkty, které e-shop ve skutečnosti prodává.
- Chudá produktová stránka prodává míň a zboží se víc vrací. V průzkumu Salsify z roku 2025 mezi 1 910 nakupujícími z USA a Velké Británie uvedlo 53 %, že nedokončili nákup kvůli neúplnému nebo špatně napsanému názvu či popisu. V průzkumu Rithum z roku 2025 mezi 6 000 spotřebiteli z pěti zemí včetně Německa a Francie vrátilo 33 % lidí zboží, protože neodpovídalo popisu nebo fotkám, a 37 % by chtělo podrobnější popisy.
- Tržišť, která musí české e-shopy plnit, přibylo. Kaufland spustil český marketplace 12. dubna 2023 a v květnu 2023 přišlo Allegro.cz. Kaufland vyžaduje EAN a výrobce u produktů ve všech kategoriích. V našich datech má EAN jen 23 % záznamů a výrobce 20 %.
- Zákon chce produktová data u každé nabídky. Od 13. prosince 2024 musí podle nařízení o obecné bezpečnosti výrobků (GPSR) každá online nabídka uvádět výrobce s poštovní a elektronickou adresou, údaje k identifikaci výrobku včetně jeho vyobrazení a případná varování a bezpečnostní informace (výklad článku 19 od MPO). V markupu to být nemusí, takže našich 20 % u výrobce o dodržování předpisů nic neříká. Údaj ale musí existovat u každého produktu.
Nejvíc to celé dopadá na velké katalogy. Na 135 českých webech s 5 000 a více produktovými záznamy má popis jen 45 % záznamů a kategorii 3 %, jak ukazuje rozbor níže.
Jak vypadají česká produktová data v crawlu z roku 2024
Strukturovaná data jsou strojově čitelná verze produktové stránky: název, cena, obrázek, značka, EAN a popis, které čtou vyhledávače, srovnávače i AI asistenti, aniž by museli rozebírat vzhled stránky. Není to celý váš katalog, ale je to ta část, kterou z něj vidí zbytek internetu.
Na doménách .cz s alespoň 50 produkty (14 875 domén, na kterých je 96 % všech produktových záznamů ve vzorku) to vypadá takto:
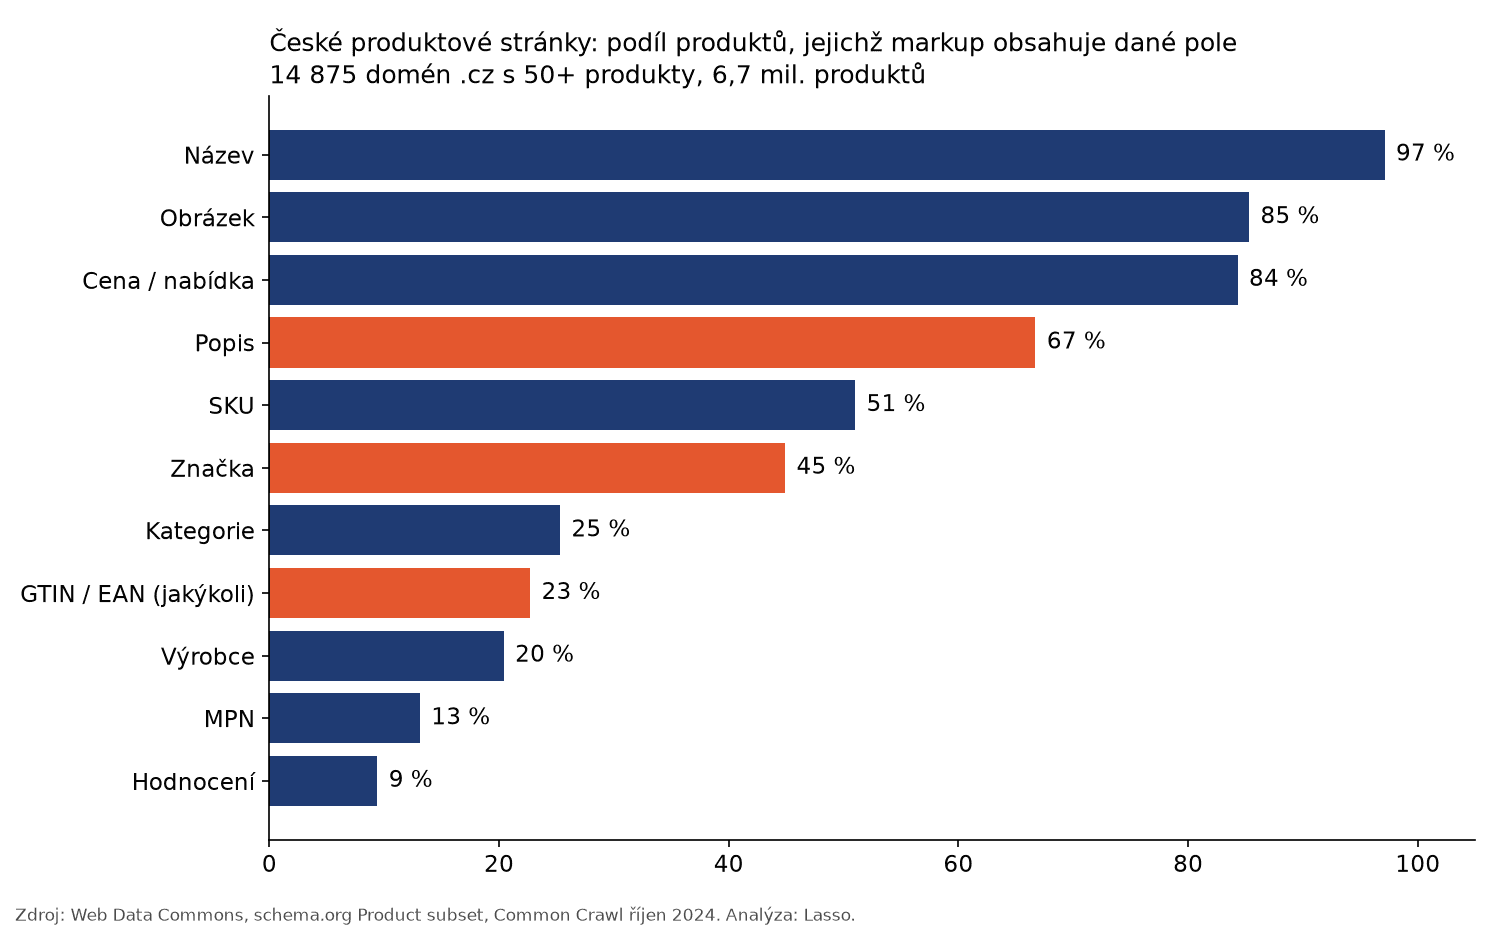
| Pole | Podíl produktových záznamů s polem |
|---|---|
| Název | 97 % |
| Obrázek | 85 % |
| Cena / nabídka | 84 % |
| Popis | 67 % |
| SKU | 51 % |
| Značka | 45 % |
| Kategorie | 25 % |
| GTIN / EAN (jakýkoli) | 23 % |
| Výrobce | 20 % |
| MPN | 13 % |
Základ, bez kterého se stránka nezobrazí, tam je. Jakmile ale jde o údaje, ze kterých stroj pozná, co je to za produkt (popis, značka, identifikátory), čísla rychle padají.
Dvě čísla vyčnívají:
- Popis: 67 %. Zhruba u každého třetího záznamu nemá vyhledávač ani srovnávač kromě názvu co číst.
- Značka: 45 %. Víc než polovina záznamů neříká, kdo produkt vyrobil.
Úplné záznamy jsou vzácné. Název, popis, obrázek, cenu i značku vyplňuje aspoň u 90 % produktů jen 35 % těchto domén. Když přidáte EAN, klesne podíl na 8 %.
Čím větší katalog, tím chudší záznamy
České domény jsme rozdělili podle toho, kolik produktových záznamů na nich crawl našel. Výsledek je jasný a pro každého, kdo spravuje velký katalog, dost nepříjemný:
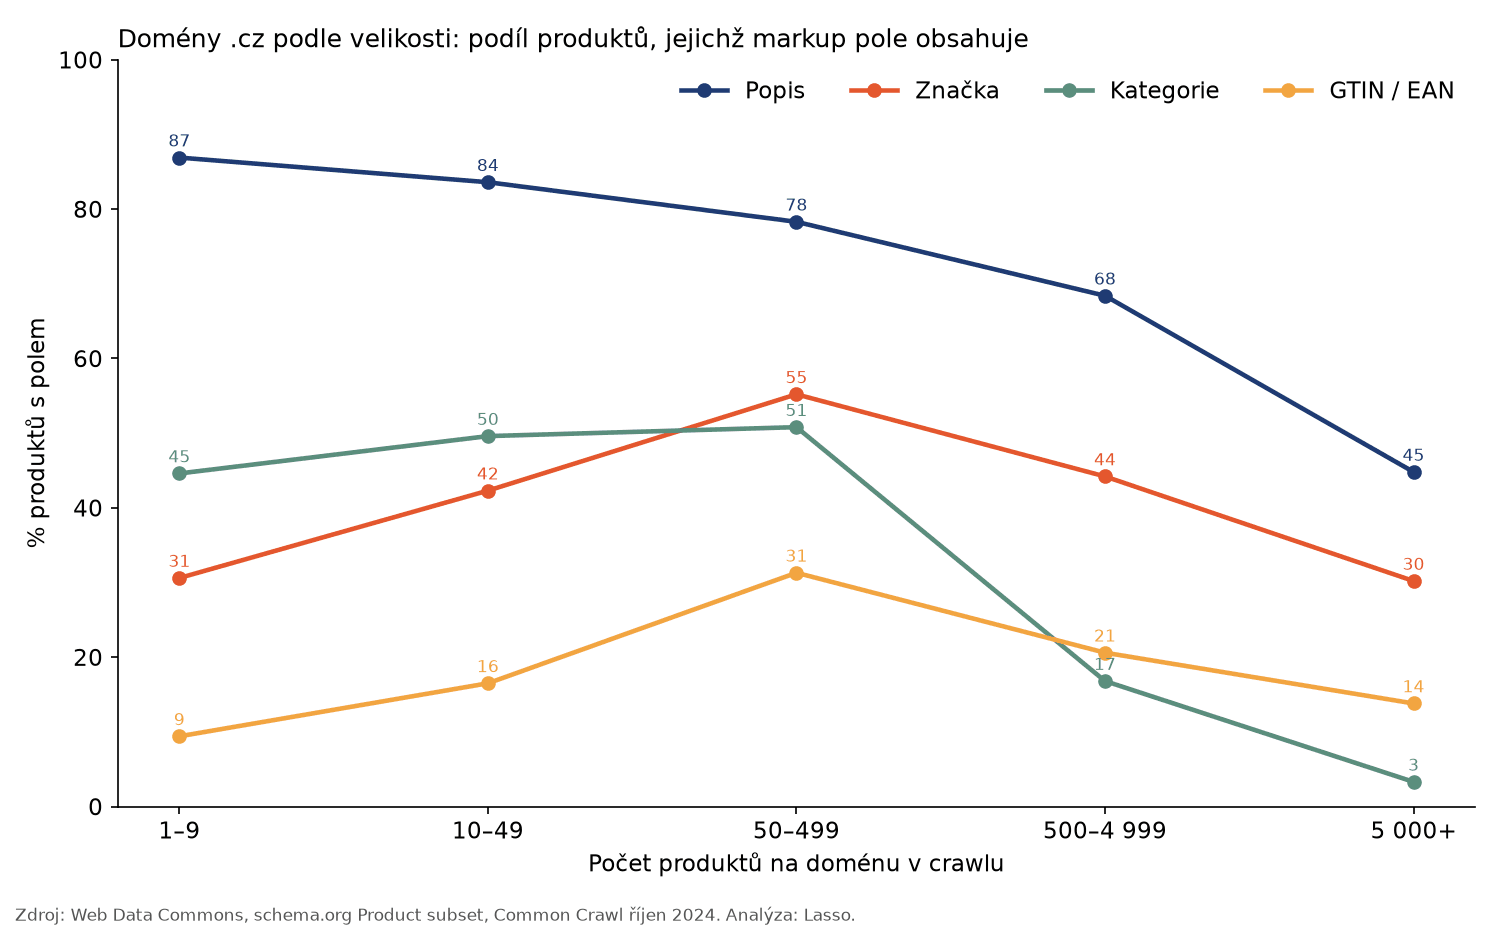
| Produktů na doménu | Domén | Popis | Značka | Kategorie | GTIN / EAN |
|---|---|---|---|---|---|
| 1–9 | 9 336 | 87 % | 31 % | 45 % | 9 % |
| 10–49 | 9 197 | 84 % | 42 % | 50 % | 17 % |
| 50–499 | 12 099 | 78 % | 55 % | 51 % | 31 % |
| 500–4 999 | 2 641 | 68 % | 44 % | 17 % | 21 % |
| 5 000+ | 135 | 45 % | 30 % | 3 % | 14 % |
- Malé weby své produkty popisují poctivě, ale značku nebo EAN uvádějí zřídka. Pravděpodobně jde často o vlastní výrobky, které GTIN ani nemají.
- Střední e-shopy (50–499 produktů) jsou nejúplnější ve značce, kategorii i EAN.
- Největší katalogy jsou nejméně úplné ve všech polích, která jsme měřili. 135 domén s 5 000 a více záznamy drží zhruba pětinu všech českých produktových záznamů ve vzorku, takže jejich mezery výrazně stahují průměr.
Část poklesu jde na vrub měření. Velké weby často označují produkty i na kategoriích a výpisech, jen s názvem a cenou, a i takové hubené záznamy se v crawlu počítají jako produkty. Závěr to ale jen zmírňuje, nevyvrací: čím větší katalog, tím víc produktů odchází bez údajů, které po nich kanály chtějí. Úplnost se ručně škálovat nedá.
V EAN a kategoriích vedou české weby region
Aby země šly férově porovnat, počítali jsme tentokrát domény, ne produkty. Pár obřích webů tak výsledek nezkreslí. Otázka zněla: jaký podíl domén s 50+ produkty vyplňuje dané pole aspoň u poloviny produktů?
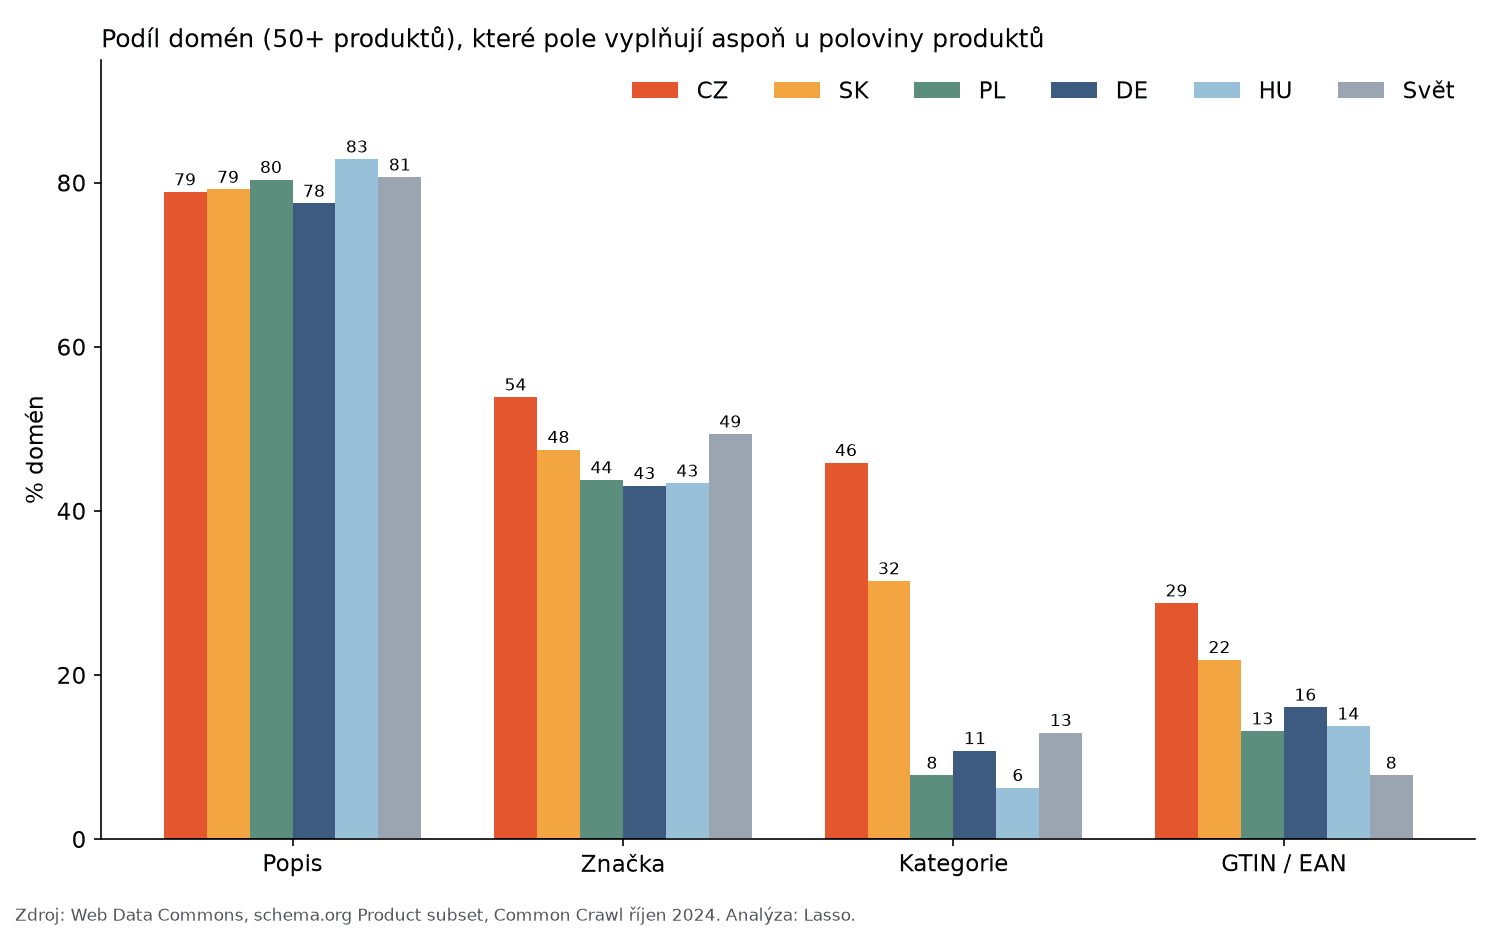
| Trh | Domén (50+ produktů) | Popis | Značka | Kategorie | GTIN / EAN |
|---|---|---|---|---|---|
| Česko (.cz) | 14 875 | 79 % | 54 % | 46 % | 29 % |
| Slovensko (.sk) | 6 455 | 79 % | 48 % | 32 % | 22 % |
| Polsko (.pl) | 20 960 | 80 % | 44 % | 8 % | 13 % |
| Německo (.de) | 47 580 | 78 % | 43 % | 11 % | 16 % |
| Maďarsko (.hu) | 7 750 | 83 % | 43 % | 6 % | 14 % |
| Všechny domény světa | 1 017 054 | 81 % | 49 % | 13 % | 8 % |
V popisech jsou české weby průměrné. Ve značce, kategorii a EAN ale vedou: GTIN uvádějí skoro dvakrát častěji než německé weby a téměř čtyřikrát častěji než světový průměr, kategorii zhruba čtyřikrát častěji než Němci.
Proč? Hypotéza: šablony e-shopových platforem
Podle vlastních údajů běží na Shoptetu zhruba 40 % českého e-commerce. Vývojářská dokumentace Shoptetu uvádí, že šablony vypisují mikrodata schema.org na detailu produktu. Na produktových stránkách veřejného demo e-shopu Shoptetu, které jsme v říjnu 2026 prošli, obsahuje markup stále stejnou sadu vlastností, mimo jiné category, manufacturer, productID a identifier.
Tuhle sadu jsme použili jako otisk:
- Nese ji 27,5 % českých domén s 50+ produkty, na Slovensku 15,7 % a v Polsku, Německu a Maďarsku nejvýš 1 %.
- Z českých domén s otiskem uvádí GTIN u většiny produktů 53 %, u ostatních 20 %.
Velká část českého náskoku tak nejspíš pramení z výchozího nastavení šablon: když e-shop vyplní EAN v administraci, šablona ho sama publikuje. Hypotézou to zůstává ze dvou důvodů. Otisk není důkaz platformy, stejné vlastnosti mohou vypisovat i jiné systémy. A šablonu jsme kontrolovali v podobě z roku 2026, zatímco crawl je z roku 2024. I bez domén s otiskem ale české weby uvádějí GTIN u většiny produktů o něco častěji (20 %) než německé (16 %), polské (13 %) nebo maďarské (13 %).
Ponaučení pro všechny ostatní: na výchozím nastavení záleží. Když platforma pole vypisuje automaticky, úzkým hrdlem se stává to, jestli je pole vůbec vyplněné.
Kolik chybějící údaje stojí při uvádění produktů na trh
Chybějící pole produktovou stránku málokdy rozbije. Zpomalí ale všechno, co produkt potřebuje potom: párování, schválení i viditelnost. Takhle to popisují v oficiální dokumentaci kanály, přes které české e-shopy prodávají.
Heureka. Heureka páruje nabídky s produktovými kartami hlavně podle kategorie, přesného názvu a EAN. Podle nápovědy dokáže EAN párování radikálně zrychlit, zároveň ale potřebuje i název, kategorii, výrobce, parametry a cenu. Povinný je EAN jen ve vybraných kategoriích, třeba u knih, hudby a filmů. Heureka také zveřejňuje průměrnou dobu párování: 4–7 dní v běžných kategoriích, 14–21 dní v kategoriích s povinným EAN a zhruba měsíc v oblečení a módě.
Zboží.cz. Srovnávač Seznamu uvádí jako hlavní faktory párování název produktu, EAN, výrobce a kód produktu. Specifikace feedu přijímá GTIN-8, 12, 13 i 14.
Google Merchant Center. Specifikace produktových dat vede popis jako povinný a značku jako povinnou u všech nových produktů kromě filmů, knih a hudby. U GTIN Google odpovídá „záleží na situaci“: důrazně ho doporučuje, kdykoli ho výrobce přidělil. Nápověda ke GTIN dodává, že produkty s chybějícím nebo chybným GTIN mohou mít omezenou viditelnost, že bez GTIN nelze zaručit přesné spárování a že produkt s přiděleným GTIN odeslaný bez něj může být zamítnut. Produkty bez GTIN mohou místo toho potřebovat značku a MPN.
Allegro. Od února 2024 vyžaduje Allegro ve vybraných kategoriích EAN. Bez něj tam nabídku nevystavíte, neupravíte ani neobnovíte. Allegro také doporučuje dohledat produkt v katalogu podle GTIN, což vystavení zkracuje.
Amazon. Amazon podle GTIN přiřadí nabídku k existujícímu listingu, nebo založí nový. Bez GTIN potřebujete nejdřív výjimku.
Teď to položte vedle čísel výše. Produkt bez značky nesplní požadavek Googlu. Produkt bez EAN a bez výrobce nechává Heureku a Zboží.cz párovat jen podle názvu, a neobvyklý název znamená ruční párování. Produkt bez popisu dává každému kanálu, i každému AI nákupnímu asistentovi, méně materiálu. Na vlastním webu se nic z toho jako chyba neukáže. Ukáže se to jako dny až týdny, než produkt jinde získá první proklik. Na trhu, kde e-shopy v roce 2025 utržily 206 miliard korun (APEK a Heureka), se ty týdny sčítají.
Nejvíc pozornosti dostává EAN a podrobně ho rozebíráme v článku o produktech bez EAN nebo GTIN. Data ale říkají, že větší mezery jsou ve značce a popisu. Jen selhávají potichu.
Co s tím dělat
Na nalezení vlastních mezer nepotřebujete crawl celého českého webu. Stačí pár hodin a export katalogu.
- Změřte vyplněnost jednotlivých polí. Vyexportujte katalog a u každého produktu spočítejte, jestli má popis, značku, výrobce, EAN, kategorii a klíčové parametry. Šablonu najdete v našem checklistu kvality produktových dat.
- Zkontrolujte, co šablona skutečně publikuje. Otevřete pár produktových stránek a podívejte se na strukturovaná data. Pokud je EAN v administraci, ale na stránce ne, je to problém šablony, ne dat. Na co se dívat, popisuje náš návod ke strukturovaným datům pro produkty.
- Začněte u největších kategorií. Data ukazují, že mezery rostou s velikostí katalogu. Začněte tam, kde máte nejvíc produktů a kde mají kanály nejpřísnější pravidla: oblečení a móda, knihy a média, kategorie s povinnými parametry.
- Doplňujte údaje před uvedením produktu, ne až po chybě ve feedu. Značka a výrobce bývají v dodavatelském souboru. EAN často najdete na obalu nebo v ceníku dodavatele. Nejvíc času zaberou popisy.
- Sledujte dobu do prvního zalistování. Měřte, kolik dní uplyne od založení produktu po první schválenou nabídku na Heurece, Zboží.cz nebo v Googlu. Podle toho poznáte, jestli se práce vyplácí. Jak takový proces postavit, jsme popsali v článku o zkrácení time-to-market u nových produktů.
Právě na tohle jsme postavili Lasso. Lasso vezme dodavatelský soubor nebo existující katalog, dohledá chybějící značky, EAN, parametry a popisy a označí, co ještě musí zkontrolovat člověk. Produkty pak odcházejí s údaji, které po nich kanály chtějí. Jestli chcete vidět, jak to vypadá na vašich datech, pošlete nám ukázkový soubor a ukážeme vám, kde máte mezery.
Metodika a omezení
Data. Podmnožina schema.org Product z Web Data Commons, vydání 2024-12, postavená na Common Crawl z října 2024 (crawl CC-MAIN-2024-42). Pokrývá 3,3 milionu domén po celém světě. Jde o domény druhého řádu, subdomény se počítají k mateřské doméně.
Rozsah. „Český“ znamená doménu končící na .cz. České e-shopy na .com nebo .eu ve vzorku chybí a některé .cz domény naopak e-shopy nejsou: patří sem i výrobci, katalogy a tržiště. Proto mluvíme o webech a doménách, ne o e-shopech.
Co jsme měřili. Podíl produktových záznamů, jejichž strukturovaná data (Microdata nebo JSON-LD) obsahují dané pole. Správnost hodnot jsme nekontrolovali: uvedený EAN může být neplatný a uvedený popis může mít jednu větu. Pole, které v markupu chybí, naopak může existovat ve feedu nebo v databázi e-shopu. Čísla popisují, co stroje přečtou na stránce, ne celý katalog.
Známá zkreslení.
- Výpisy a kategorie, které označují produkty jen názvem a cenou, stahují průměry dolů, nejvíc u velkých webů. Šablony Shoptetu například na výpisech mikrodata nepoužívají, jiné platformy ano.
- Web Data Commons spojuje Microdata a JSON-LD bez deduplikace, takže produkt označený oběma formáty se počítá dvakrát.
- Common Crawl stránky vzorkuje a neprochází každou stránku každého webu. Počet záznamů na doménu tedy odráží pokrytí crawlu, ne velikost katalogu.
- Data jsou z konce roku 2024. E-shopy se od té doby změnily a analýzu zopakujeme na novějších crawlech.
Rozpad podle oborů. Statistiky po doménách neobsahují spolehlivé hodnoty kategorií, takže jsme výsledky podle oborů raději nerozdělovali, než abychom hádali.
Soukromí. Uvádíme jen skupiny domén, jednotlivé e-shopy nejmenujeme ani neřadíme.
Jak kvalitu katalogu ve velkém řeší jiné týmy, najdete v našich případech použití.